AI 短剧的连续性状态表:一个人物,三个镜头
用三镜头泡茶故事,明确人物、道具与场景状态,再把有意的变化与没有解释的偏差分开检查。
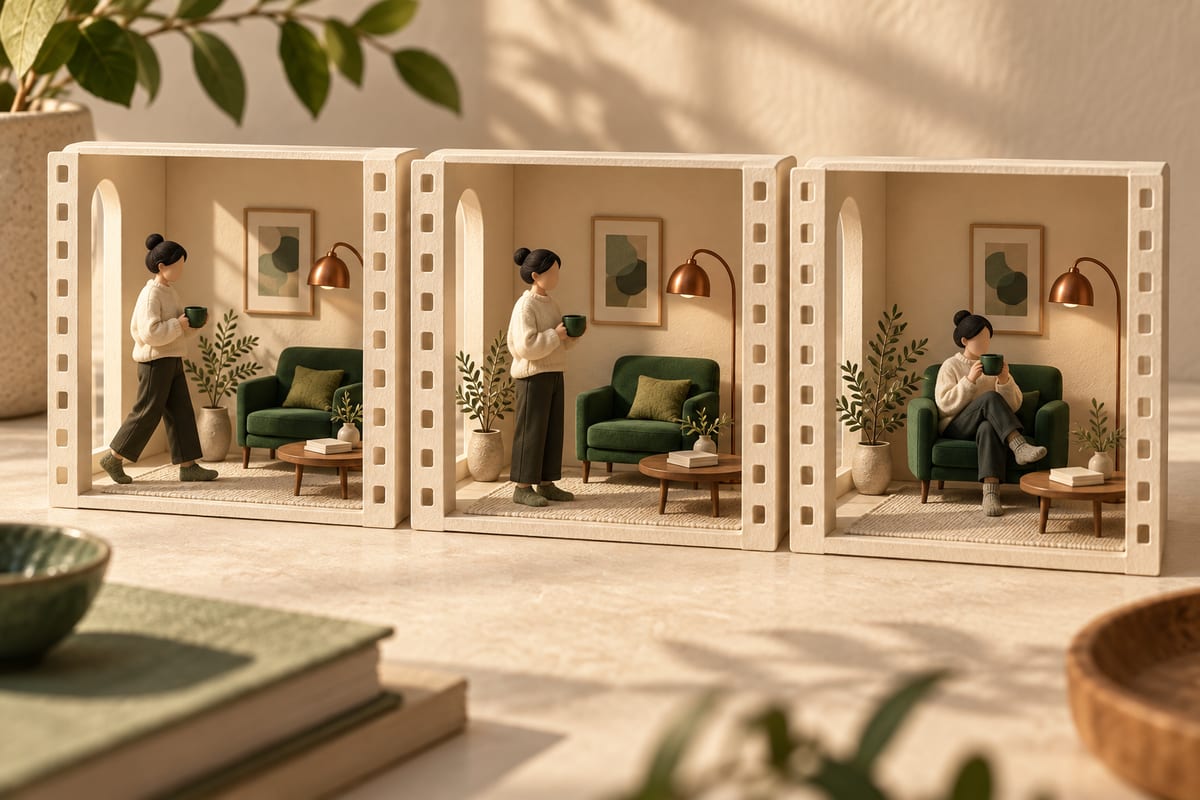
先讲一个变化看得见的小故事
Google 9 月 24 日的研究博文 ↗讨论了用于长视频一致性的多代理调度与视觉记忆。下面是独立设计的三镜头练习,不是对该研究系统的复现。
练习很简单:小林泡茶,走到走廊喝一口,再回厨房放下杯子。整段可以按约二十秒规划,只有一个人物、一件关键道具和两个场景。使用你已有的工具即可,不要求某个指定模型,也不要求部署论文系统。
目标是保留本来应该固定的事实,同时让一个变化有清楚的原因:满杯的茶在喝过之后变成半杯。一致性不意味着所有细节都不能变,而是变化能被观众理解。
生成前,先写连续性状态表
用自己的话准备一张简短参考表:小林穿纯蓝色围裙,黄色腕带戴在左手腕;杯子是红色,杯柄旁有一个小白点;厨房水壶始终在台面右侧,窗户始终在左侧。
参考图可以来自你自己的绘画,或你有权使用的图片。它们是创作参考,不代表工具一定能准确复现每个细节。
| 镜头 | 场景与人物 | 杯子的进入状态 → 结束状态 | 预定动作 |
|---|---|---|---|
| 1 | 厨房;蓝围裙、左手黄色腕带 | 空杯,位于水壶左侧 → 满杯,右手拿着 | 小林倒茶并拿起杯子 |
| 2 | 走廊;相同服装与腕带 | 满杯,右手拿着 → 半杯,仍由右手拿着 | 小林明确喝一口 |
| 3 | 厨房;台面布局和服装相同 | 半杯,右手拿着 → 半杯,放在水壶右侧 | 小林返回并放下杯子 |
杯子从水壶左侧移到右侧,是刻意安排的变化,不应判为错误。没有解释就突然出现绿杯子,或厨房窗户换了位置,才是连续性问题。
每个镜头都写清进入状态和结束状态
每个镜头只描述它必须完成的动作,再补充相关的固定细节、起点和终点。例如镜头 2 可以这样写:
“小林走进走廊,穿着已确定的蓝色围裙,黄色腕带在左手腕。右手拿着已确定的红杯子,杯内茶水是满的。小林清楚地喝一口。镜头结束时,同一个杯子变成半杯,仍拿在右手。”
这是一种建议的写法,不是适用于所有模型的统一指令。请根据所用工具支持的参考图、片段时长和控制方式调整。如果现有控制无法可靠表达某个细节,就简化场景,不必无限追加指令。
让同一状态贯穿多个镜头
- 人物
身份 · 服装 · 姿态
- 道具
外观 · 位置
- 场景
空间 · 光线 · 方向
先检查接缝,再看完整故事
先比较镜头 1 的最后一帧与镜头 2 的第一帧,再检查镜头 2 和镜头 3 的连接处。核对面孔、服装、腕带、杯子特征和茶水多少。随后完整播放一遍,不暂停观看;静态画面衔接正确,也可能掩盖某个动作根本没有发生。
问题清单只记三件事:镜头编号、观察到的偏差、准备尝试的最小修改。腕带换到另一只手,可以调整该镜头的参考图或构图;喝茶动作缺失,就修改动作说明。修正改变了共享状态时,再检查相邻镜头;否则尽量保留已经通过检查的镜头。
一个二十分钟的小练习
用五分钟准备状态表和参考资料,十分钟生成或拼接粗剪,再用五分钟检查。记录每次尝试,以及实际花费的时间或费用。
把每项要求标为“能看见且正确”“不正确”或“无法判断”。腕带被遮住,不等于已经验证它没有变化。如果关键事实看不清,下一次就换一个更清楚的构图,或先从故事要求中移除这项细节。
通过标准是一段能逐镜头说明、关键变化都有原因的短片。本文不声称已有实测成绩,也不保证生成结果;这个练习的价值,是留下可复用的记录:哪些事实必须保留,哪些变化允许发生,哪些问题还需要修正。
读懂之后,再动手试一次。
看看下一篇无需登录,同一浏览器在不同语言中只计一次。
原始参考资料
这些资料用于核查与继续学习,来源不代表对本刊的背书。
research.google参考原文 1