RAG 回答不准,先检查文章是怎样被切开的
把文章存进知识库后,AI 依然可能回答错。问题有时发生在检索阶段:它找到了一段看起来相关的文字,却不知道那段文字属于哪一种模型、哪次实验或哪一篇文章。切分内容时保留背景,是一个值得先检查的地方。
三个月免费开放 · 至 2027 年 1 月 10 日(日本时间),所有文章均可阅读全文。
RAG 的基本思路是先找资料,再让模型根据资料回答。检索到的内容如果丢失上下文,生成阶段就容易沿着错误的前提继续解释。Anthropic 的 Contextual Retrieval 文章介绍了给片段补充局部背景,以及结合词项与语义检索的方法。参考原文 ↗
假设你保存了一篇硬件评测,其中有一句“在这个设置下,占用约 8GB”。把它单独切成片段,读者问“我需要多大的显存”时,模型可能找到了这句话,但不知道“这个设置”指的是哪种精度、输入长度和并发数。
可以给片段附上文章标题、小节名、发布日期以及必要的条件。例如:这段来自某次单用户推理实验,采用特定量化方式,数字只适用于该实验设置。背景需要来自原文,不能由模型猜补。
也要注意问题的不同形式。型号、错误码、函数名通常需要准确匹配;“为什么运行久了更占内存”则更接近语义问题。混合检索值得测试,但是否有效,仍需用你自己的问题验证。
视觉札记
试一试
准备十个读者真实会问的问题。对比两种知识库:一种只保存片段正文,另一种加上标题和实验条件。先检查是否找到正确资料,再检查回答是否正确。两步分别记录,能避免把检索问题误判成模型问题。
不要把厂商在其数据集上的提升百分比,直接写成你的知识库也能达到的效果。
把原理,切开来看
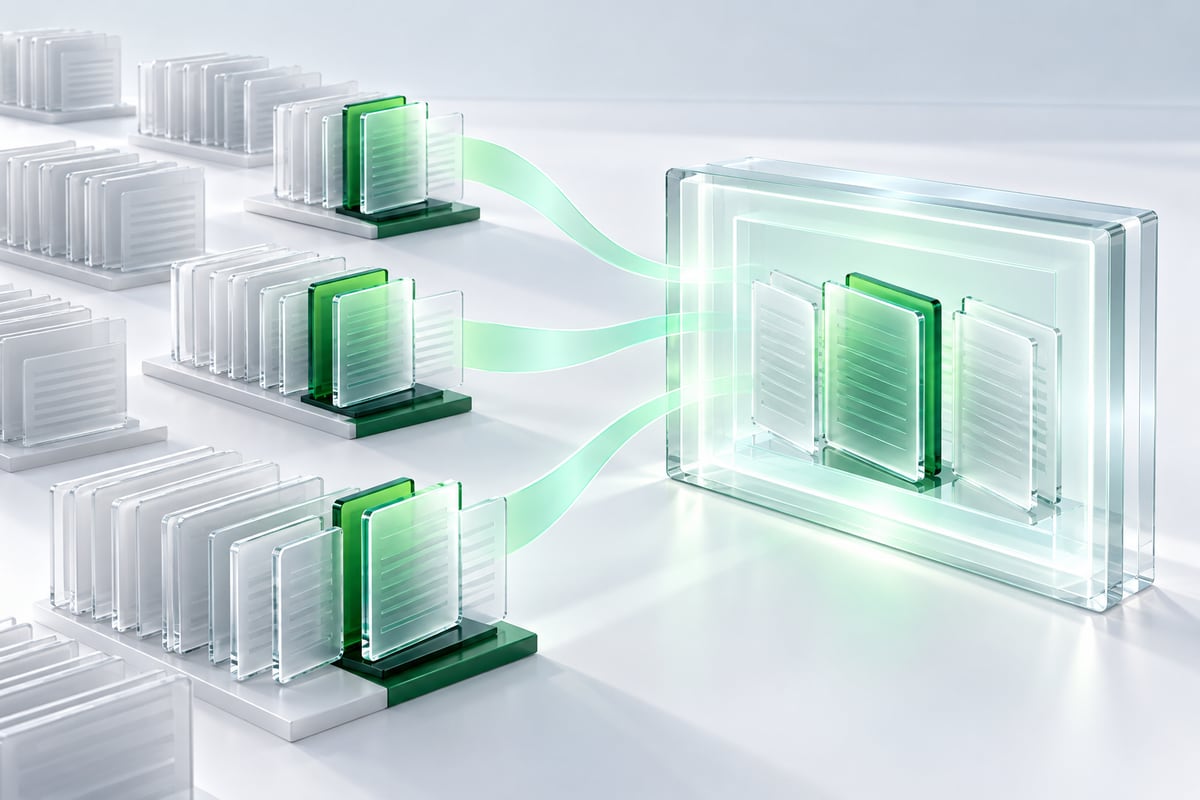
有用的片段,要带着上下文
- 原始来源
文档 · 日期 · 主题
- 检索片段
相关文字与背景
- 形成回答
可核查的引用
读懂之后,再动手试一次。
看看下一篇这篇文章对你有帮助吗?
正在读取点赞…无需登录,同一浏览器在不同语言中只计一次。
原始参考资料
这些资料用于核查与继续学习,来源不代表对本刊的背书。
www.anthropic.com参考原文 1