RAG の回答が不正確なら、まず文書の分割方法を確認する
記事をナレッジベースに保存しても、AI が誤った回答をすることがあります。原因が検索段階にある場合、関連して見える文章は見つかっていても、それがどのモデル、実験、記事についての記述か分かっていません。文書を分割するときに背景情報が残っているか、まず確認する価値があります。
RAG の基本は、まず資料を検索し、その資料に基づいてモデルに回答させることです。取得した内容から文脈が失われていると、生成段階で誤った前提のまま説明が続きやすくなります。Anthropic の Contextual Retrieval の記事では、各チャンクに周辺の背景情報を補う方法と、キーワード検索と意味検索を組み合わせる方法を紹介しています。参考記事 ↗
保存したハードウェアのレビューに、「この設定では、使用量は約 8GB」という一文があるとします。これだけを独立したチャンクにすると、読者が「VRAM はどれくらい必要ですか」と質問した際、モデルはその文を見つけても、「この設定」がどの精度、入力長、同時実行数を指すか分かりません。
チャンクには、記事のタイトル、節の見出し、公開日、必要な条件を付けられます。たとえば、特定の量子化方式を用いた単一ユーザー向け推論実験の記述であり、この数値はその実験条件にのみ当てはまる、と明示します。背景情報は原文に基づく必要があり、モデルの推測で補ってはいけません。
質問の形の違いにも注意しましょう。型番、エラーコード、関数名は正確な一致が必要になりやすい一方、「長く動かすとメモリ使用量が増えるのはなぜか」は意味に基づく検索に近い問いです。ハイブリッド検索は試す価値がありますが、有効かどうかは自分の質問で検証する必要があります。
試してみる
読者が実際に尋ねそうな質問を 10 問用意してください。チャンクの本文だけを保存したナレッジベースと、タイトルや実験条件も付けたものを比較します。まず正しい資料が見つかったかを確認し、次に回答が正しいかを確認しましょう。この 2 段階を別々に記録すると、検索の問題をモデルの問題と取り違えにくくなります。
ベンダーが自社のデータセットで示した改善率を、そのまま自分のナレッジベースでも達成できる効果として書かないでください。
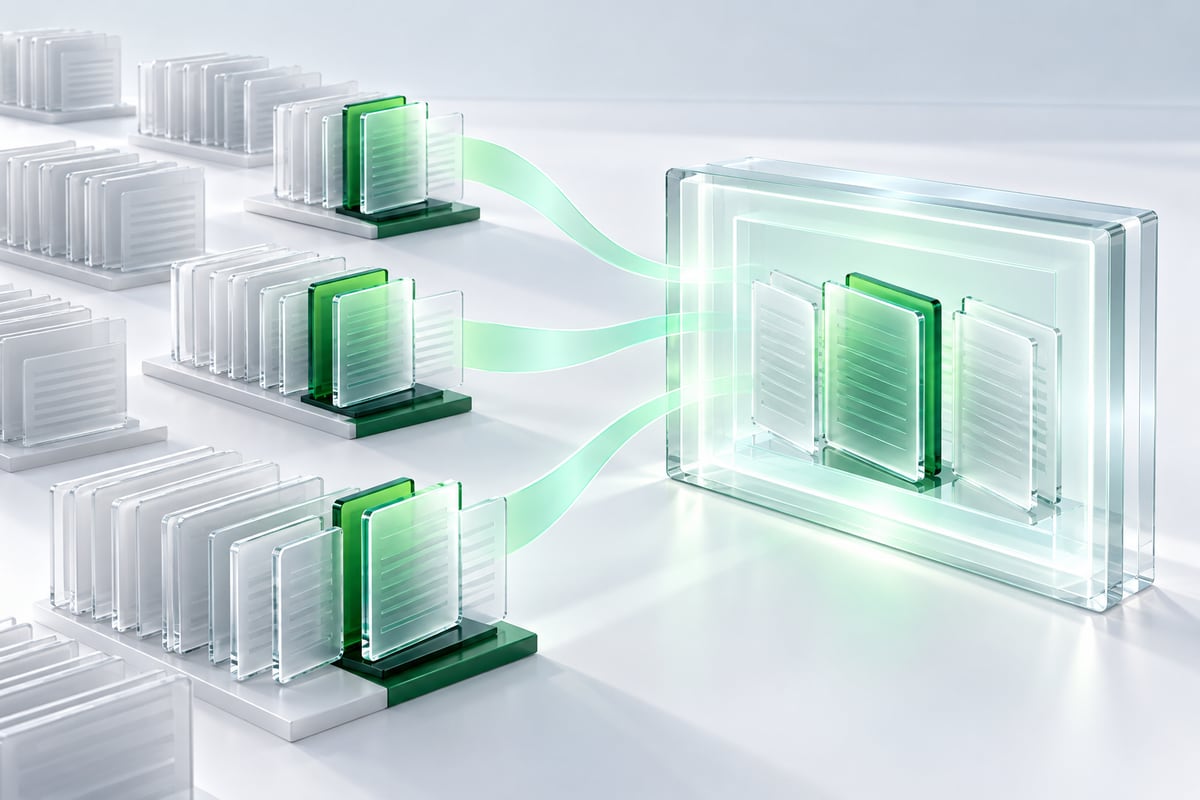
役立つ抜粋には文脈がある
- 原資料
文書・日付・対象
- 取得した箇所
関連する文章と背景
- 回答
確認できる参照
理解したら、実際に試してみましょう。
次の記事を探すログイン不要。同じブラウザでは、言語を変えても1票です。
原資料・参考リンク
内容の確認と学習のためのリンクです。資料の掲載は本誌への推薦や支持を意味しません。
www.anthropic.com原資料 1